

Un commerciale estrae un nuovo elenco di potenziali clienti, passa i nomi attraverso uno strumento di ricerca email e carica ogni risultato in una sequenza di contatto. L’elenco sembra completo, ma le risposte restano scarse, i bounce aumentano e la reputazione del mittente, costruita in mesi, inizia a deteriorarsi. Il problema di solito non è l’assenza di dati. È presumere che un indirizzo trovato sia automaticamente raggiungibile, attivo, pertinente e sicuro da contattare.
Per trovare account email che generano davvero conversioni, considera la ricerca come il primo passo di un workflow integrato. L’arricchimento aggiunge contesto, la verifica testa la raggiungibilità tecnica e il punteggio di rischio determina se un indirizzo debba essere incluso in una sequenza, richieda una revisione o debba essere escluso. Questa distinzione è importante in un ecosistema frammentato di caselle email, dove uno studio globale del 2024 condotto su 15 provider di servizi email ha riportato un posizionamento medio nella posta in arrivo dell’83,1%, il che significa che il 16,9% delle email legittime non è riuscito a raggiungere la posta in arrivo (statistiche sulla deliverability di EmailToolTester).
Il controllo della realtà della prospezione via email nel 2026
Un SDR può creare un ampio file di prospect in un pomeriggio. I nomi provengono da un fornitore di dati, i titoli vengono arricchiti tramite profili professionali e uno strumento di ricerca genera un indirizzo probabile per ogni persona. All'inizio la campagna può sembrare efficace perché la sequenza è completa e i dati appaiono strutturati. Poi il dominio di invio inizia a ricevere rinvii, gli indirizzi generici assorbono i messaggi e il team scopre che molti contatti “validi” non erano mai stati buoni prospect.
I flussi di lavoro basati esclusivamente sulla scoperta producono rendimenti decrescenti perché i provider delle caselle valutano più del semplice fatto che un indirizzo esista. Esaminano la cronologia del mittente, i modelli di engagement, i segnali di autenticazione, il contenuto dei messaggi e il comportamento dei destinatari. Una casella tecnicamente raggiungibile può comunque indirizzare un messaggio nella cartella spam, ignorarlo o associare il mittente a comunicazioni indesiderate.
Regola pratica: Un elenco più grande non è un elenco migliore se il team non sa spiegare perché ogni indirizzo è raggiungibile e merita di essere contattato.
L'approccio precedente era semplice: raccogliere gli indirizzi, caricarli in una sequenza e rimuovere i bounce in seguito. Questo processo tratta i problemi di consegna come una questione di reporting. Un flusso di lavoro moderno li considera invece un problema di dati da risolvere prima dell'invio. Il record utile non è solo name + email. Include il ruolo attuale della persona, il contesto aziendale, la fonte, il metodo di scoperta, il risultato della verifica, lo stato catch-all, lo stato dell'account di ruolo, l'indicatore di dominio usa e getta e il segnale d'acquisto che giustifica il contatto.
La portata dell'email moderna spiega anche perché la diversità dei provider è importante. Gmail è stato lanciato nel 2004, Google ha riferito 1 miliardo di utenti attivi mensili nel 2016 e Gmail ha successivamente superato 1,8 miliardi di utenti nel 2020, secondo il contesto storico riassunto da EmailToolTester. Trovare account email oggi significa lavorare tra provider consumer e aziendali con comportamenti di filtraggio diversi, non associare semplicemente un nome a un dominio familiare.
La prospezione con l'AI e la verifica in tempo reale stanno diventando centrali in questo cambiamento, mentre le norme sulla privacy rendono più difficile difendere la raccolta indiscriminata. La copertura del settore identifica questi cambiamenti come sviluppi importanti nel mercato degli strumenti per trovare email (panoramica attuale dei flussi di lavoro per trovare email). La conclusione pratica è semplice: la scoperta aggiunge un candidato all'elenco, ma la verifica e il punteggio di rischio determinano se il candidato appartiene all'attività di outreach. Per una panoramica più ampia di come l'automazione stia cambiando le operazioni email, la Bibbia dell'email marketing con AI di BillionVerify è una risorsa complementare utile.
Operatori di ricerca e ipotesi sui pattern come base
Gli operatori di ricerca restano utili quando fanno emergere un contesto professionale pubblico, anziché informazioni personali private. Inizia dal dominio dell'azienda e dal ruolo della persona, quindi restringi la ricerca:
site:linkedin.com "@company.com" intitle:"VP Operations"
Usa le virgolette intorno ai nomi esatti o ai frammenti di dominio. Aggiungi una località, un'unità aziendale o un precedente datore di lavoro quando l'insieme dei risultati è troppo ampio. Una variante filetype:pdf può far emergere biografie per conferenze, pagine di relatori, documenti per investitori e altro materiale pubblico in cui può comparire un indirizzo professionale. Gli operatori con il segno meno aiutano a escludere i risultati irrilevanti, come:
site:example.com "@example.com" -jobs -careers
Queste query non dimostrano che un indirizzo sia attivo. Forniscono elementi utili per l'arricchimento dei dati e aiutano a distinguere una casella nominativa da un indirizzo generico come info@, support@ o sales@.
Costruisci il pattern del dominio
L'ipotesi sui pattern funziona meglio quando conosci già il dominio e disponi di diversi esempi confermati. Raccogli da cinque a dieci indirizzi noti da pagine pubbliche dell'azienda, conversazioni precedenti o fonti di dati autorizzate. Uniforma le maiuscole, rimuovi gli alias e raggruppa formati come:
first.last@example.comflast@example.comfirstl@example.comfirst@example.com
Poi classifica i pattern in base alla frequenza con cui compaiono. Se un formato prevale, usalo per creare un indirizzo candidato per un nuovo contatto. Non considerare il candidato come un risultato. Consideralo un input per la verifica.
Un riepilogo di un benchmark del 2026 ha riportato che l'ipotesi basata esclusivamente sui pattern ha raggiunto circa il 60% quando erano noti sia il dominio dell'azienda sia il nome di una persona. Lo stesso riepilogo ha rilevato tassi di individuazione verificata compresi tra il 20% e il 77,5% tra gli strumenti indipendenti in un test su 5.000 contatti, dimostrando quanto i risultati dipendano dalla qualità e dal metodo di arricchimento (benchmark del flusso di lavoro per trovare email).
Adegua le aspettative agli elementi disponibili
| Pattern | Esempio | Tasso medio di corrispondenza |
|---|---|---|
| Nome e cognome | first.last@example.com | Dipendente dal dominio |
| Iniziale del nome e cognome | flast@example.com | Dipendente dal dominio |
| Nome e iniziale del cognome | firstl@example.com | Dipendente dal dominio |
| Solo nome | first@example.com | Dipendente dal dominio |
| Casella di ruolo | sales@example.com | Non corrisponde a una persona |
I domini catch-all limitano ciò che i test sui pattern possono indicare, perché il server di posta può accettare quasi qualsiasi destinatario. I record WHOIS protetti dalla privacy e le configurazioni email orientate alla privacy creano punti ciechi simili. In questi casi, un indirizzo ipotizzato può sembrare plausibile senza fornire una conferma utile.
La sequenza pratica è cercare, dedurre, verificare e classificare. Usa la guida all'estrazione massiva di email per un flusso di estrazione più ampio, ma non lasciare che l'estrazione diventi la metrica di successo. Un indirizzo candidato ha valore solo dopo che il team ne conosce lo stato tecnico, il tipo di casella e il rischio di contatto.
LinkedIn, strumenti di arricchimento e fornitori di dati a confronto
LinkedIn è efficace per l'identità e il contesto. Può mostrare il datore di lavoro attuale, il titolo professionale, la posizione geografica e la storia professionale, rendendolo prezioso per la prospezione basata sugli account. In genere non fornisce un indirizzo di lavoro verificato per ogni persona, quindi i team lo abbinano a uno strumento di arricchimento o a un motore di ricerca di indirizzi email.
Le piattaforme di arricchimento come Apollo, Clearbit e i sistemi simili a ZoomInfo possono collegare una persona, il dominio aziendale e un URL di profilo noto a un probabile indirizzo aziendale. Il loro vantaggio è la velocità dei flussi di lavoro e un contesto strutturato più ampio. Il loro limite è che la copertura varia in base al mercato, alle dimensioni dell'azienda, alla geografia e alla frequenza di aggiornamento di ciascun record. I fornitori di dati in blocco offrono volume ed esportazioni pratiche, ma i record obsoleti creano rischi operativi quando i team li caricano senza un passaggio di verifica.
Confronta i compromessi operativi
| Canale | Copertura | Costo/record | Aggiornamento | Conformità |
|---|---|---|---|---|
| Ricerca su LinkedIn | Forte contesto sull'identità e sul ruolo, soprattutto per i professionisti visibili | Maggiore impegno umano | Spesso riflette l'attività attuale del profilo | Lo scraping può entrare in conflitto con i termini della piattaforma |
| API di arricchimento | Utili per il matching strutturato di aziende e contatti | Basato sull'utilizzo o dipendente dalla piattaforma | Dipende dai cicli di aggiornamento della fonte | Richiede raccolta, utilizzo e conservazione leciti |
| Fornitori di dati in blocco | Ampia copertura nella parte alta del funnel | Minore impegno marginale su larga scala | Può degradarsi rapidamente senza verifica | Richiede attenta gestione della provenienza, soppressione e controlli di audit |
| Siti web aziendali e documenti pubblici | Alta pertinenza per i contatti pubblicati | Basso costo diretto di acquisizione, maggiore impegno di ricerca | Cambia con gli aggiornamenti del sito | Utilizzare solo informazioni appropriate per il contatto previsto |
Per un quadro più approfondito sulla scelta tra queste categorie, confronto tra strumenti di arricchimento dei dati è un riferimento utile, perché la decisione implica più del semplice conteggio delle funzionalità. La copertura delle piccole imprese differisce da quella delle aziende enterprise, e un costo di acquisizione apparentemente basso può scomparire quando un team sostiene i costi della revisione manuale, della gestione dei rimbalzi e della sostituzione delle liste.
I termini di LinkedIn limitano alcune forme di scraping automatizzato. Il GDPR influisce sulla base giuridica, sulla trasparenza, sulla conservazione e sull'utilizzo dei dati personali. Il CAN-SPAM disciplina le pratiche relative alle email commerciali negli Stati Uniti, mentre il CASL impone requisiti di consenso più rigorosi per molti messaggi commerciali canadesi, in particolare nei contesti rivolti ai consumatori. La revisione legale dovrebbe tenere conto della posizione del destinatario, del ruolo del mittente, della fonte dei dati e del tipo di campagna.
Il record più economico è spesso quello che richiede meno correzioni a valle.
Utilizza LinkedIn insieme all'arricchimento per attività basate sugli account ad alto coinvolgimento, dove l'accuratezza del ruolo è importante. Utilizza un fornitore di dati in blocco per la prospezione su larga scala solo quando il flusso di lavoro include controlli sulla provenienza, logica di soppressione e verifica. Un motore di ricerca di email LinkedIn di BillionVerify può integrarsi nel percorso dalla scoperta alla verifica, ma la decisione dovrebbe comunque basarsi sulla qualità dei dati e sull'utilizzo previsto, non solo sull'etichetta della fonte.
Come funziona davvero la verifica dietro le quinte
La verifica delle email non consiste in una singola domanda con risposta sì o no. È una sequenza di test che risponde a domande diverse sullo stesso indirizzo.
Il primo livello controlla l'indirizzo stesso
La validazione della sintassi verifica se la stringa segue un formato email accettabile. Individua gli indirizzi malformati, gli spazi accidentali, i componenti di dominio mancanti e altri errori evidenti prima che il sistema esegua i controlli di rete. Questo livello dovrebbe anche identificare gli account di ruolo come info@, support@ e sales@.
Un account di ruolo non è necessariamente non recapitabile. Rappresenta una decisione di contatto diversa. Instradalo verso un flusso di lavoro per caselle condivise o contatti aziendali invece di trattarlo come un referente nominativo.
Il secondo livello controlla il dominio
I controlli DNS e MX determinano se il dominio risolve correttamente e se dispone di un mail exchanger in grado di ricevere email. Un dominio può esistere senza essere una destinazione affidabile per l'indirizzo in esame. Domini parcheggiati, domini configurati erroneamente e host sinkhole possono far sembrare un candidato più credibile di quanto sia realmente.
Il terzo livello analizza il comportamento della casella
Un handshake SMTP si connette al mail server ricevente, identifica il destinatario previsto e legge la risposta del server senza inviare il messaggio. Il flusso standard controlla la sintassi, lo stato del dominio e la risposta a livello di casella (come funziona la verifica delle email).
I domini catch-all complicano il livello finale. Se un server accetta ogni destinatario, il verificatore può ricevere la stessa risposta di accettazione per una casella reale e una inventata. Questo risultato dovrebbe essere classificato come catch-all, invece di essere promosso a “sicuro”. Anche i domini usa e getta richiedono un flag separato, perché le caselle temporanee possono essere tecnicamente raggiungibili pur rimanendo inadatte a comunicazioni commerciali o di marketing durature.
Una risposta di verifica utile dovrebbe esporre più di un singolo stato. La documentazione dell'API BillionVerify descrive campi strutturati per stato, recapitabilità, punteggio di qualità, livello di rischio, codici motivazionali e flag separati per indirizzi usa e getta, account di ruolo, catch-all e webmail gratuiti. Specifica inoltre che l'API risponde in meno di 3 secondi (API di validazione delle email).
Il verdetto dovrebbe attivare un'azione. Sopprimi i record non validi, instrada gli account di ruolo verso una gestione diversa, metti in attesa i catch-all per una revisione, separa gli indirizzi usa e getta dalle comunicazioni durature e passa gli indirizzi nominativi a basso rischio alla fase successiva di scoring.
Integrare la verifica nel tuo stack di outreach
La verifica funziona meglio come checkpoint durante il processo, non come attività di pulizia dopo il fallimento di una campagna. L'integrazione giusta dipende da dove il tuo team crea i record e dalla rapidità con cui questi record devono essere trasferiti.
Controlli API in tempo reale
Uno scraper, un servizio di arricchimento o un processo waterfall può chiamare immediatamente un'API di verifica dopo aver prodotto un indirizzo. Il sistema memorizza la risposta accanto al contatto e blocca i record non validi o ad alto rischio prima che raggiungano il CRM. Questo modello è adatto alle operazioni ad alto volume perché impedisce ai dati errati di diffondersi in più sistemi downstream.
Il compromesso riguarda la latenza sincrona e i costi di utilizzo. Una chiamata in tempo reale aggiunge un punto decisionale al flusso di arricchimento, ma evita anche di pagare le conseguenze manuali dell'invio prima e della pulizia successiva.
Convalida lato CRM
Un workflow di HubSpot o Salesforce può eseguire un passaggio di verifica quando un lead entra in uno stato qualificato o immediatamente prima dell'iscrizione a una sequenza. Il codice personalizzato o un connettore di automazione può scrivere il risultato in campi come verification_status, risk_level, catch_all e last_verified_at.
Questo approccio è utile quando più canali di acquisizione alimentano un unico CRM. Il rischio riguarda i tempi. Se lo stesso indirizzo è stato verificato molto tempo fa, un controllo prima della sequenza è più affidabile che fidarsi di un campo obsoleto.
Workflow con agenti AI e MCP
Gli agenti AI possono usare la verifica come chiamata a uno strumento durante la prospezione autonoma. L'agente individua una persona, arricchisce il record, invia il candidato alla verifica e interrompe il processo o richiede una revisione quando la risposta indica un indirizzo catch-all, usa e getta, basato su un ruolo o ad alto rischio.
Questo modello impedisce all'agente di considerare una stringa email plausibile come un risultato definitivo. Crea inoltre un chiaro limite di confidenza. L'agente può continuare solo quando le evidenze soddisfano le regole della campagna.
| Modello | Punto di attivazione | Latenza | Ideale per | Compromesso |
|---|---|---|---|---|
| API | Immediatamente dopo la scoperta o l'arricchimento | Quasi in tempo reale | Flussi ad alto volume e arricchimento waterfall | Aggiunge una chiamata e richiede la gestione degli errori |
| MCP | Durante la sequenza di prospezione di un agente AI | Dipende dalla chiamata allo strumento | Ricerca autonoma con soglie di confidenza | Richiede permessi dell'agente definiti con attenzione |
| CRM | Prima della qualificazione o dell'iscrizione alla sequenza | Dipende dal workflow | Operazioni di vendita centralizzate | Può essere troppo tardi se i dati errati si sono già diffusi |
Usa tre trigger operativi: verifica dopo lo scraping, verifica immediatamente prima dell'invio della sequenza e ripeti la verifica dei record obsoleti secondo una cadenza definita. Un workflow email pratico dovrebbe tenere conto del rischio della casella e dell'inbox placement, invece di affidarsi a un unico controllo. Le indicazioni sulla deliverability delle cold email possono aiutare i team a collegare i controlli tecnici alle pratiche di invio.
La verifica prima dell'invio è misurabile. Un benchmark del 2026 ha riportato tassi di hard bounce inferiori allo 0,5% tra i marketer che hanno verificato le liste prima delle campagne, rispetto all'1,8%–3,2% degli invii non verificati negli stessi settori (benchmark dei tassi di bounce delle email). Inserisci la verifica a monte del warmup e dell'invio, non dopo il primo report di bounce. Per i team che elaborano database esistenti, la verifica massiva delle liste email dovrebbe avvenire prima che il sequencer riceva il file.
Perché un indirizzo valido non è un indirizzo sicuro
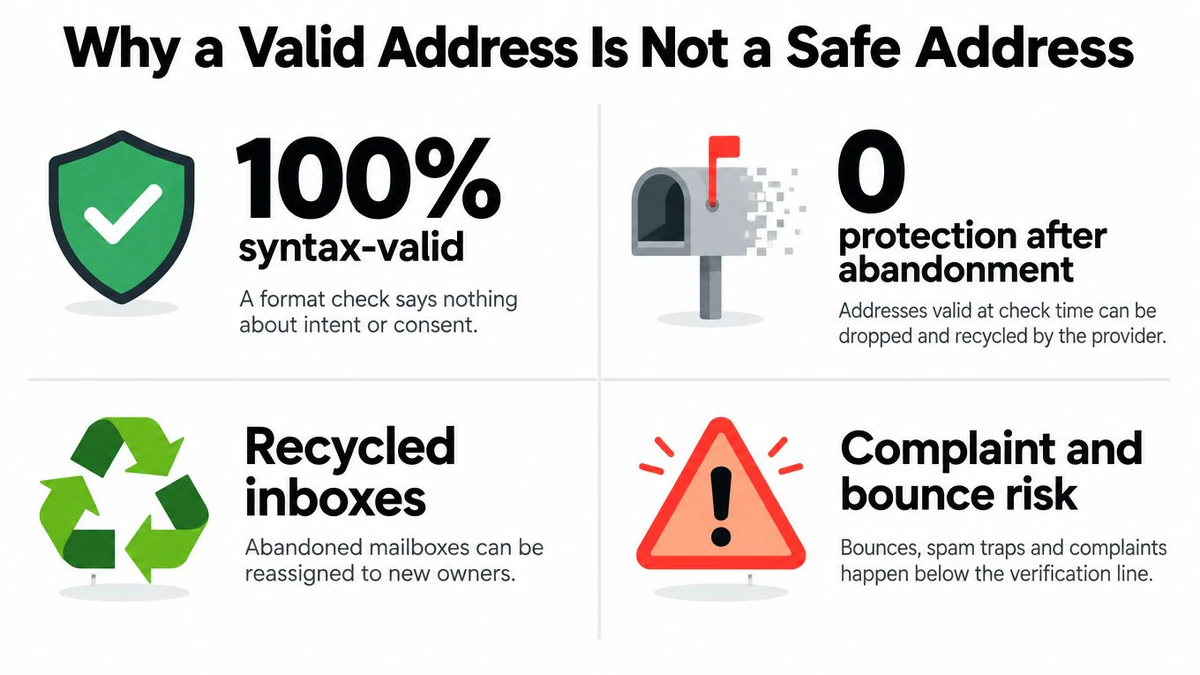
Un risultato di verifica positivo risponde a una domanda circoscritta: l'indirizzo sembrava tecnicamente raggiungibile al momento del test. Non conferma che la persona desideri ricevere il tuo messaggio, che la casella rimanga attiva o che il dominio goda di una buona reputazione presso il tuo mittente.
Un indirizzo può superare i controlli di sintassi e appartenere comunque a un account di ruolo. Un dominio può accettare traffico SMTP filtrando al contempo in modo aggressivo i mittenti sconosciuti. Una casella può essere valida oggi e abbandonata in seguito. Un contatto può anche rimanere perfettamente raggiungibile e segnalare come spam il tuo precedente contatto, creando un problema di rischio per il mittente che nessun controllo della casella può risolvere.
Separare la validità tecnica dal rischio della campagna
Mantieni questi concetti in campi separati:
- Stato della casella: indica se il sistema ricevente ha accettato il controllo di verifica.
- Tipo di indirizzo: indica se il contatto è una persona identificata per nome, un account di ruolo, un indirizzo di webmail gratuito o una casella usa e getta.
- Comportamento del dominio: indica se il dominio è catch-all o restituisce una risposta che limita il livello di certezza.
- Rischio di coinvolgimento: indica se gli invii precedenti hanno prodotto mancato coinvolgimento, reclami, rinvii o altri segnali negativi.
- Stato del consenso: indica se il destinatario ha rinunciato o se manca una base giuridica difendibile per la comunicazione prevista.
Su larga scala, la verifica può osservare gran parte del livello SMTP, ma non può garantire il futuro recapito nella posta in arrivo. Un benchmark del 2026 che ha analizzato 10,241,981 verifiche su 293,934 domini ha rilevato 12.3% di indirizzi non validi, 33.1% di domini catch-all e solo 19% degli indirizzi ricontrollati ancora validi dopo 90 giorni (benchmark sulla deliverability delle email). Questi dati rendono chiaro un punto operativo: un vecchio risultato positivo non dovrebbe rimanere valido per sempre.
Un indirizzo valido è un'istantanea. Una decisione sicura di contatto è un record mantenuto aggiornato.
La riverifica dovrebbe essere attivata in base all'età dei dati, alla sensibilità della campagna e alla categoria di rischio. Escludi gli indirizzi che non superano i controlli successivi, isola i catch-all per una revisione più rigorosa e interrompi gli invii ai contatti che rinunciano o generano segnali di reclamo. Una pulizia continua non elimina ogni problema di reputazione, ma impedisce al team di confondere una risposta tecnica passata con una garanzia permanente.
Il flusso di lavoro completo e la checklist di conformità
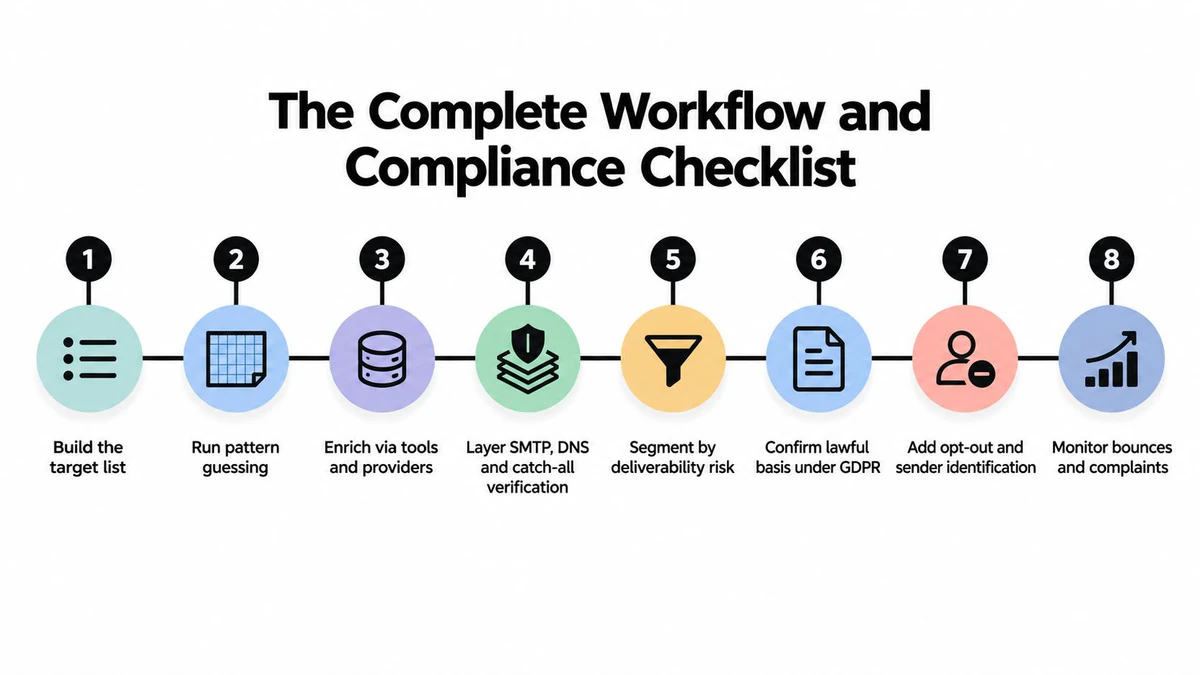
Un processo affidabile fa passare ogni record attraverso gli stessi controlli:
- Crea l’elenco target. Definisci account, ruolo, area geografica e segnale d’acquisto. Produci un record di contatto con una fonte e un motivo per l’inclusione.
- Esegui la ricerca per pattern. Usa prove pubbliche e formati di dominio noti per creare candidati. Produci un indirizzo candidato, non una verità presunta.
- Arricchisci tramite strumenti e provider autorizzati. Aggiungi azienda attuale, ruolo, fonte e contesto rilevante. Conserva la provenienza.
- Verifica sintassi, DNS, SMTP e comportamento catch-all. Salva il risultato, i codici motivazione e il timestamp.
- Segmenta in base al rischio di recapito. Separa gli indirizzi non validi, basati su ruoli, usa e getta, catch-all, free-webmail e gli indirizzi nominativi a rischio più basso.
- Conferma la base giuridica. Documenta il motivo per cui il team può trattare e utilizzare il contatto secondo il quadro normativo sulla privacy applicabile.
- Applica soppressione e controlli sul mittente. Rispetta le richieste di rinuncia, identifica chiaramente il mittente e impedisci ai record soppressi di rientrare nelle campagne future.
- Monitora e verifica nuovamente. Tieni traccia di bounce, reclami, differimenti e coinvolgimento, quindi aggiorna i record obsoleti prima di un’altra sequenza.
Il livello di conformità deve essere integrato nel flusso di lavoro, non confinato in un documento di policy che il sistema di invio non legge mai. Mantieni una traccia di audit chiara per ogni contatto, sopprimi gli indirizzi basati su ruoli e personali che non dovrebbero ricevere la campagna, rispetta le informazioni applicabili provenienti da DNSBL e spam trap e usa il double opt-in quando la campagna o la giurisdizione lo richiede. I team dovrebbero inoltre verificare se la fonte dei dati consente l’uso previsto e se la conservazione rimane necessaria.
Tieni questo breve runbook accanto al processo outbound: acquisisci il record, deduci con cautela, arricchisci legalmente, verifica subito, assegna il punteggio di rischio, sopprimi le eccezioni, inserisci nella sequenza solo i contatti idonei e ricontrolla i dati obsoleti. Questa sequenza trasforma “trovare account email” da un’attività di scraping in un’operazione di revenue controllata.
BillionVerify offre la verifica professionale delle email per controlli singoli, pulizia di liste in blocco e workflow in tempo reale, con dati strutturati sul recapito e sul rischio a supporto di questo processo dalla scoperta alla verifica. Visita BillionVerify per valutare come i suoi strumenti di convalida possano aiutare il tuo team a rimuovere gli indirizzi rischiosi prima che raggiungano una sequenza di outreach.