

営業担当者は新しい見込み客リストを用意し、メール検索ツールで名前を調べ、すべての結果をアウトリーチシーケンスに登録します。リストは完全に見えますが、返信は低調なままで、バウンス率は上昇し、数か月かけて築いた送信者レピュテーションは悪化し始めます。問題は通常、データがないことではありません。見つかったアドレスなら自動的に到達可能で、利用中で、関連性があり、安全にメッセージを送れると想定してしまうことです。
実際に成約につながるメールアカウントを見つけるには、検索を連携したワークフローの最初のステップとして扱います。エンリッチメントでコンテキストを追加し、検証で技術的な到達可能性をテストし、リスクスコアリングで、そのアドレスをシーケンスに含めるべきか、確認が必要か、または配信対象から除外すべきかを判断します。この違いは、メールボックスのエコシステムが分断されている現在、重要です。2024 年に 15 社のメールサービスプロバイダーを対象に実施された世界規模の調査では、平均受信トレイ到達率が 83.1% でした。つまり、正規のメールの 16.9% が受信トレイに届かなかったことになります(EmailToolTester のメール到達率統計)。
2026 年のメールプロスペクティングの現実チェック
SDR は、午後の数時間で大規模な見込み客ファイルを作成できます。名前はデータプロバイダーから取得し、役職はプロフェッショナルプロフィールから補完し、ファインダーが各人物の推定メールアドレスを生成します。シーケンスが埋まり、データが整理されているように見えるため、キャンペーンは最初は成功しているように見えるかもしれません。しかしその後、送信ドメインで遅延が発生し始め、汎用アドレスがメッセージを受け取り、チームは多くの「有効な」連絡先が、そもそも優れた見込み客ではなかったことに気付きます。
発見のみに依存するワークフローは、メールボックスプロバイダーがアドレスの存在だけで判断するわけではないため、成果が次第に低下します。プロバイダーは、送信者の履歴、エンゲージメントパターン、認証シグナル、メッセージ内容、受信者の行動を評価します。技術的に到達可能なメールボックスであっても、メッセージをスパムに振り分けたり、無視したり、送信者を望ましくないアウトリーチと関連付けたりする可能性があります。
実践的なルール: 各アドレスが到達可能で、連絡する価値がある理由をチームが説明できないなら、リストは大きいほど良いとは限りません。
以前のアプローチは単純でした。アドレスを集め、シーケンスに読み込み、後からバウンスを削除します。このプロセスでは、配信の問題をレポート上の課題として扱います。現代的なワークフローでは、配信の問題を送信前のデータ問題として扱います。役立つレコードは単なる name + email ではありません。対象者の現在の役割、会社のコンテキスト、ソース、発見方法、検証結果、キャッチオールのステータス、ロールアカウントのステータス、使い捨てドメインのフラグ、そして連絡を正当化する購買シグナルが含まれます。
現代のメール規模を考えると、プロバイダーの多様性が重要な理由も明らかです。Gmail は 2004 年 に開始され、Google は 2016 年 に月間アクティブユーザーが 10 億人 に達したと報告し、EmailToolTester がまとめた歴史的背景によると、Gmail はその後 2020 年 までに 18 億人 を超えました。現在メールアカウントを見つけるには、名前を見慣れたドメインに一致させるのではなく、異なるフィルタリング動作を持つ消費者向けおよびビジネス向けのプロバイダーを横断して対応する必要があります。
AI プロスペクティングとリアルタイム検証は、この変化の中心になりつつあります。一方で、プライバシールールにより、無差別な収集を正当化することは難しくなっています。業界報道では、これらの変化がメールファインダー市場における主要な発展として取り上げられています(現在のメールファインダーワークフローに関する報道)。実践的な結論は明快です。発見によって候補者がリストに加わり、検証とリスクスコアリングによって、その候補者をアウトリーチに含めるべきかどうかが決まります。自動化がメール運用をどのように変えているかをさらに詳しく知りたい場合は、BillionVerify AI メール Bible が役立つ参考資料です。
検索演算子とパターン推測を基盤にする
検索演算子は、個人的な非公開情報ではなく、公開された職業上のコンテキストを明らかにする場合に、引き続き有用です。まず会社のドメインとその人物の役職から始め、検索範囲を絞り込みます。
site:linkedin.com "@company.com" intitle:"VP Operations"
完全一致の名前やドメインの一部には、引用符を使用します。検索結果が多すぎる場合は、所在地、事業部門、または以前の勤務先を追加します。filetype:pdf を使ったバリエーションでは、会議の略歴、講演者ページ、投資家向け文書、その他の公開資料が見つかり、そこに業務用メールアドレスが記載されている場合があります。マイナス演算子を使うと、次のように無関係な結果を除外できます。
site:example.com "@example.com" -jobs -careers
これらのクエリによって、アドレスが有効であることが証明されるわけではありません。エンリッチメントのための根拠が得られ、名前付きメールボックスと、info@、support@、sales@ などの汎用アドレスを区別するのに役立ちます。
ドメインパターンを構築する
パターン推測は、ドメインがすでに分かっており、確認済みの例が複数ある場合に最も効果を発揮します。公開企業ページ、過去のやり取り、または許可されたデータソースから、既知のアドレスを 5 ~ 10 件収集します。大文字と小文字を統一し、エイリアスを削除して、次のような形式に分類します。
first.last@example.comflast@example.comfirstl@example.comfirst@example.com
次に、出現頻度に基づいてパターンを順位付けします。1 つの形式が大半を占める場合は、それを使って新しい連絡先の候補アドレスを作成します。候補を結果として扱ってはいけません。検証への入力として扱います。
2026 年のベンチマーク概要では、会社のドメインと人物の名前の両方が分かっている場合、パターン推測だけで 約 60% に到達したと報告されています。同じ概要では、5,000 件の連絡先を対象としたテストで、単独ツールによる検証済みの発見率が 20% ~ 77.5% の範囲に及ぶことも示されており、結果がエンリッチメントの品質と手法に大きく左右されることが分かります(メール検索ワークフローのベンチマーク)。
期待値を根拠に合わせる
| パターン | 例 | 平均一致率 |
|---|---|---|
| 名と姓 | first.last@example.com | ドメインによって異なる |
| 名のイニシャルと姓 | flast@example.com | ドメインによって異なる |
| 名と姓のイニシャル | firstl@example.com | ドメインによって異なる |
| 名のみ | first@example.com | ドメインによって異なる |
| 役割用メールボックス | sales@example.com | 個人との一致ではない |
キャッチオール型のドメインでは、メールサーバーがほぼすべての受信者を受け入れる可能性があるため、パターンテストで分かることが限られます。プライバシー保護された WHOIS レコードや、プライバシーを重視したメール設定でも、同様の盲点が生じます。そのような場合、推測したアドレスはもっともらしく見えても、有用な確認にはなりません。
実務上の手順は、検索、推測、検証、分類です。より幅広い抽出ワークフローについては、一括メール抽出ガイドを利用できますが、抽出を成功指標にしてはいけません。候補アドレスに価値が生まれるのは、チームがその技術的ステータス、メールボックスの種類、アウトリーチのリスクを把握した後だけです。
LinkedIn、エンリッチメントツール、データプロバイダーの比較
LinkedIn は、身元確認とコンテキストの把握に強みがあります。現在の勤務先、役職、地域、キャリア履歴を確認できるため、アカウントベースのプロスペクティングに役立ちます。ただし、すべての人物について検証済みの勤務先メールアドレスが得られるわけではないため、通常はエンリッチメントツールやメールファインダーと組み合わせて利用します。
Apollo、Clearbit、ZoomInfo 系のシステムなどのエンリッチメントプラットフォームは、人物、企業ドメイン、既知のプロフィール URL を結び付け、可能性の高い業務用メールアドレスを特定できます。利点は、ワークフローの迅速化と、構造化されたコンテキストをより広範に取得できることです。一方、カバレッジは市場、企業規模、地域、各レコードが最後に更新された時期によって異なります。バルクデータプロバイダーは、大量データと便利なエクスポート機能を提供しますが、検証ゲートなしでアップロードすると、古いレコードが業務上のリスクを生みます。
運用上のトレードオフを比較する
| チャネル | カバレッジ | コスト / レコード | 最新性 | コンプライアンス |
|---|---|---|---|---|
| LinkedIn リサーチ | 特に公開情報の多い専門職について、身元と役職のコンテキストに強い | 人手の負担が大きい | 現在のプロフィール活動を反映することが多い | スクレイピングはプラットフォーム規約に抵触する可能性がある |
| エンリッチメント API | 企業と連絡先の構造化されたマッチングに有用 | 利用量ベースまたはプラットフォーム依存 | データソースの更新サイクルによる | 合法的な収集、利用、保持が必要 |
| バルクデータプロバイダー | ファネル上部の幅広いカバレッジ | 大量処理では限界コストが低い | 検証しないと急速に劣化する可能性がある | 出所、抑制、監査の各管理を慎重に行う必要がある |
| 企業ウェブサイトと公開文書 | 公開された連絡先との関連性が高い | 直接の取得コストは低いが、調査負担は大きい | サイトの更新に応じて変化する | 意図した連絡先に適切な情報のみを使用する |
これらのカテゴリーから選択するための、より詳しいフレームワークについては、データエンリッチメントツールの比較 が有用な参考資料です。これは、判断が機能の数だけで決まるものではないためです。小規模企業のカバレッジはエンタープライズのカバレッジとは異なり、見かけ上の取得コストが低くても、手動レビュー、バウンス対応、リストの差し替えに費用をかけると、その優位性が失われる可能性があります。
LinkedIn の規約では、特定の形式の自動スクレイピングが制限されています。GDPR は、個人データの適法な根拠、透明性、保管、利用に影響します。CAN-SPAM は米国における商用メールの慣行を規定し、CASL は多くのカナダ向け商用メッセージ、特に消費者向けの文脈で、より厳格な同意要件を課しています。法務レビューでは、受信者の所在地、送信者の役割、データソース、キャンペーンの種類を考慮する必要があります。
最も安価なレコードとは、多くの場合、その後の修正を最も必要としないレコードです。
役職の正確性が重要な、きめ細かなアカウントベースの施策では、LinkedIn とエンリッチメントを組み合わせて使用します。幅広いプロスペクティングにバルクプロバイダーを使用する場合は、出所確認、抑制ロジック、検証をワークフローに組み込んでください。BillionVerify LinkedIn メールファインダー は発見から検証までのプロセスに組み込めますが、判断はソースの名称だけでなく、データ品質と intended use に基づいて行うべきです。
検証が実際に内部で機能する仕組み
メール検証は、単純な「はい」か「いいえ」の質問ではありません。同じアドレスについて異なる疑問に答える、一連のテストです。
第 1 層ではアドレス自体を確認する
構文検証では、その文字列が許容されるメール形式に従っているかを確認します。ネットワークチェックを実行する前に、形式不正のアドレス、誤って入力されたスペース、ドメイン要素の欠落、その他の明らかなエラーを検出します。この層では、info@、support@、sales@ などのロールアカウントも特定する必要があります。
ロールアカウントは、必ずしも配信不能とは限りません。これは、異なるアプローチの判断を示すものです。名前付きの担当者と同じように扱うのではなく、共有受信トレイまたは企業連絡先のワークフローに振り分けます。
第 2 層ではドメインを確認する
DNS および MX チェックでは、ドメインが解決されるか、またメールを受信できるメールエクスチェンジャーが存在するかを確認します。ドメインが存在していても、確認対象のアドレスにとって健全な送信先とは限りません。パークドドメイン、設定ミスのあるドメイン、シンクホールホストによって、実際よりも信頼できそうに見える候補が生じることがあります。
第 3 層ではメールボックスの挙動を調査する
SMTP ハンドシェイクでは、受信メールサーバーに接続し、意図した受信者を特定して、メッセージを送信せずにサーバーの応答を読み取ります。標準的なフローでは、構文、ドメインの健全性、メールボックスレベルの応答を確認します(メール検証の仕組み)。
キャッチオールドメインでは、最終層の判断が複雑になります。サーバーがすべての受信者を受け入れる場合、検証ツールは実在するメールボックスと架空のメールボックスに対して、同じ受け入れ応答を受け取る可能性があります。この結果は「安全」と格上げするのではなく、キャッチオールとして分類する必要があります。使い捨てドメインにも別のフラグが必要です。一時的な受信トレイは技術的には到達可能でも、継続的な営業やマーケティングコミュニケーションには適していない場合があるためです。
有用な検証レスポンスには、単一のステータス以上の情報が含まれるべきです。BillionVerify API ドキュメントでは、ステータス、メール到達率、品質スコア、リスクレベル、理由コードに加え、使い捨て、ロールアカウント、キャッチオール、無料 Web メールの各フラグを個別の構造化フィールドとして説明しています。また、API の応答時間は 3 秒未満 と記載されています(メール検証 API)。
判定結果は、アクションにつなげる必要があります。無効なレコードは抑制し、ロールアカウントは別の処理に振り分け、キャッチオールはレビューのため保留し、使い捨てアドレスは継続的なアプローチから分離します。そして、リスクの低い名前付きアドレスを次のスコアリング段階に進めます。
アウトリーチスタックへの検証の組み込み
検証は、キャンペーンが失敗した後のクリーンアップ作業ではなく、処理の途中に設けるチェックポイントとして機能させるのが最も効果的です。適切な統合方法は、チームがどこでレコードを作成し、それらをどれほど速く移動させる必要があるかによって決まります。
リアルタイム API チェック
スクレイパー、エンリッチメントサービス、またはウォーターフォールプロセスは、アドレスの生成直後に検証 API を呼び出せます。システムはレスポンスをコンタクトの横に保存し、無効または高リスクのレコードが CRM に到達する前にブロックします。このパターンは、大量処理に適しています。悪いデータが複数の下流システムに広がるのを防げるためです。
トレードオフは、同期処理による遅延と利用コストです。リアルタイム呼び出しを追加すると、エンリッチメントフローに判断ポイントが加わりますが、先に送信して後からクリーンアップする場合に発生する手作業のコストを避けられます。
CRM 側の検証
HubSpot または Salesforce のワークフローは、リードが適格な状態になったとき、またはシーケンス登録の直前に検証ステップを実行できます。カスタムコードまたは自動化コネクタによって、結果を verification_status、risk_level、catch_all、last_verified_at などのフィールドに書き込めます。
この方法は、複数の獲得チャネルから 1 つの CRM にデータが流れ込む場合に便利です。リスクはタイミングです。同じアドレスがかなり前に検証されていた場合、古いフィールドを信頼するよりも、シーケンス前のチェックの方が信頼性が高くなります。
AI エージェントと MCP ワークフロー
AI エージェントは、自律的な見込み客開拓中に、ツール呼び出しとして検証を利用できます。エージェントは人物を発見し、レコードをエンリッチし、候補を検証にかけ、レスポンスがキャッチオール、使い捨て、ロールベース、または高リスクを示した場合に停止するか、レビューを依頼します。
このパターンにより、エージェントがもっともらしいメール文字列を完成した結果として扱うのを防げます。また、明確な信頼度の境界も作成できます。エージェントは、証拠がキャンペーンのルールを満たす場合にのみ処理を継続できます。
| パターン | トリガーポイント | 遅延 | 最適な用途 | トレードオフ |
|---|---|---|---|---|
| API | 発見またはエンリッチメントの直後 | ほぼリアルタイム | 大量処理フローとウォーターフォールエンリッチメント | 呼び出しが追加され、障害処理が必要 |
| MCP | AI エージェントの見込み客開拓シーケンス中 | ツール呼び出しに依存 | 信頼度ゲートを備えた自律的なリサーチ | エージェント権限を慎重に定義する必要がある |
| CRM | 適格性確認またはシーケンス登録の前 | ワークフローに依存 | 集中管理された営業オペレーション | 悪いデータがすでに広がっていると遅すぎる可能性がある |
3 つの運用トリガーを使用します。スクレイピング後に検証する、シーケンス処理の直前に検証する、そして定めた間隔で古くなったレコードを再検証する、という 3 つです。実用的なメールワークフローでは、1 回のチェックだけに頼らず、メールボックスのリスクと受信トレイへの配置を考慮する必要があります。コールドメールのメール到達率 に関するガイダンスは、チームが技術的なチェックと送信方法を結び付けるのに役立ちます。
送信前の検証は測定可能です。ある 2026 年のベンチマークでは、キャンペーン前にリストを検証したマーケターのハードバウンス率は 0.5% 未満でした。同じ業界で未検証のまま送信した場合は、1.8% から 3.2% でした(メールのバウンス率ベンチマーク)。検証は、最初のバウンスレポートの後ではなく、ウォームアップと送信の前段階に置きます。既存のデータベースを処理するチームにとって、一括メールリスト検証 は、シーケンサーがファイルを受け取る前に行うべき処理です。
有効なアドレスが安全なアドレスとは限らない理由
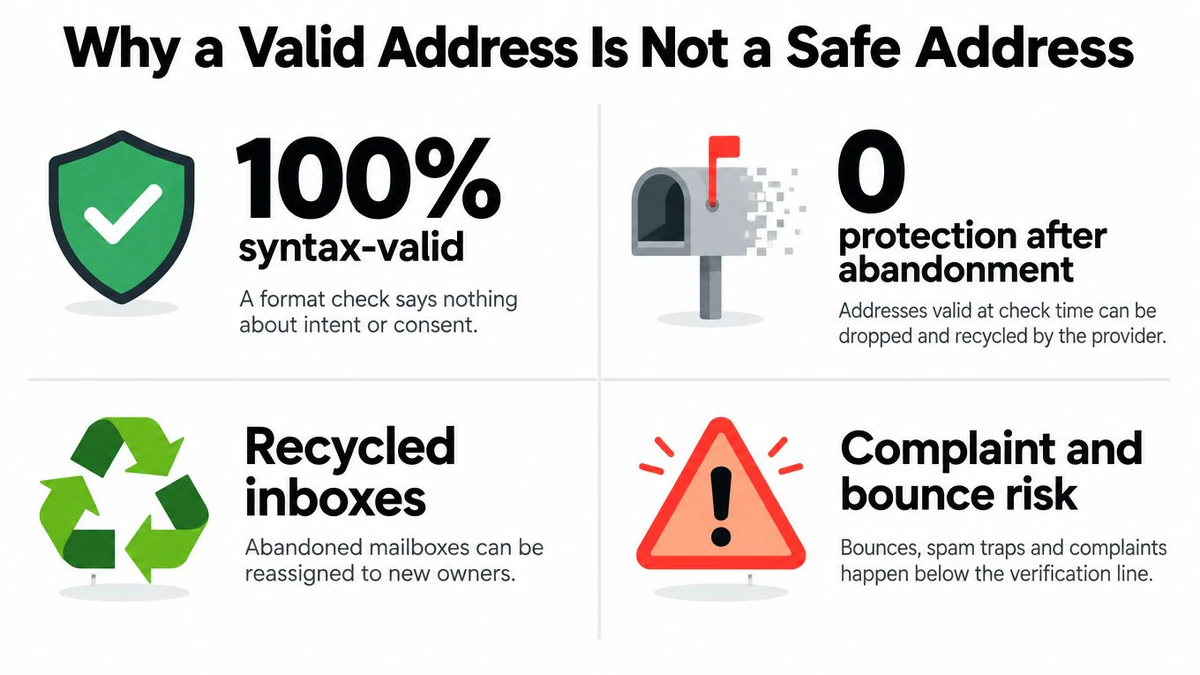
緑色の検証結果が答えるのは、限定的な質問です。つまり、テスト実行時にそのアドレスが技術的に到達可能だったということです。相手があなたのメッセージを望んでいること、メールボックスが現在も有効であること、またはそのドメインがあなたの送信元に対して良好な評判を持っていることまでは確認できません。
アドレスは構文チェックに合格しても、部署・役割アカウントである可能性があります。ドメインは SMTP トラフィックを受け入れながら、未知の送信者を厳しくフィルタリングすることもあります。メールボックスは今日有効でも、後に放棄される可能性があります。また、連絡先が完全に到達可能な状態でも、過去のアプローチをスパムとして報告することがあり、これはメールボックスプローブでは解決できない送信者リスクの問題を生み出します。
技術的な有効性とキャンペーンリスクを分ける
これらの概念は別々のフィールドで管理してください。
- メールボックスのステータス: 受信システムが検証プローブを受け入れたかどうか。
- アドレスの種類: 連絡先が個人名義、役割アカウント、無料ウェブメールアドレス、または使い捨てメールボックスのいずれであるか。
- ドメインの挙動: ドメインがキャッチオールか、確実性を制限する応答を返すかどうか。
- エンゲージメントリスク: 過去の送信でエンゲージメント、苦情、遅延、その他のネガティブシグナルが発生していないか。
- 許可のステータス: 受信者がオプトアウトしているか、意図したコミュニケーションについて正当な法的根拠を示せないかどうか。
大規模な運用では、検証によって SMTP レイヤーの多くを確認できますが、将来の受信トレイへの配置を保証することはできません。293,934 ドメインにおける 10,241,981 件の検証を対象とした 2026 年のベンチマークでは、12.3% が無効なアドレス、33.1% がキャッチオールドメインであり、**再検証したアドレスのうち 19%**のみが 90 日後も有効でした(メール到達率のベンチマーク)。これらの数値から、運用上の重要な点が明らかになります。過去の合格結果を永続的なものとして扱うべきではありません。
有効なアドレスはスナップショットです。安全なアプローチ判断は、継続的に管理される記録です。
再検証は、データの経過期間、キャンペーンの重要度、リスクカテゴリに基づいて実行してください。後続チェックで失敗したアドレスは送信対象から除外し、キャッチオールはより厳格なレビュー用に分離し、オプトアウトした連絡先や苦情シグナルを生成した連絡先への送信を停止します。継続的なリスト衛生管理ですべての評判問題を排除できるわけではありませんが、チームが過去の技術的な応答を恒久的な保証と取り違えることを防げます。
完全なワークフローとコンプライアンスチェックリスト
信頼できるプロセスでは、各レコードを同じゲートに通します。
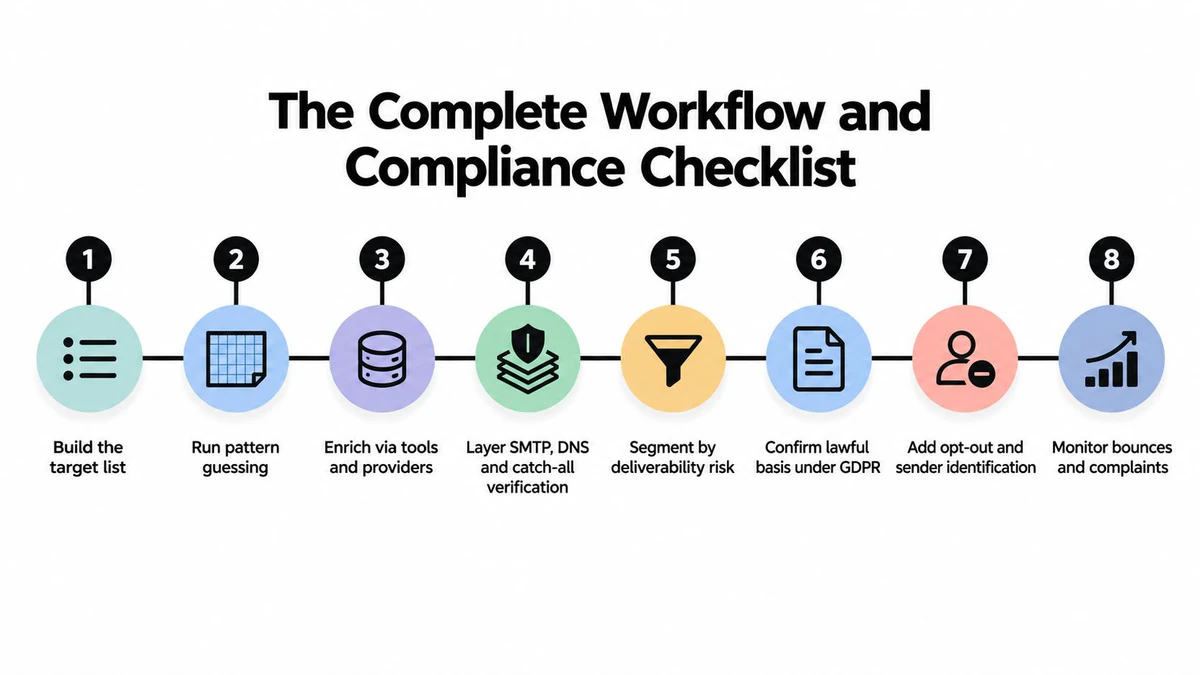
- ターゲットリストを作成する。 アカウント、役職、地域、購買シグナルを定義します。含める情報源と理由を備えた連絡先レコードを出力します。
- パターン推測を実行する。 公開情報と既知のドメイン形式を使って候補を作成します。確定情報ではなく、候補アドレスとして出力します。
- 許可されたツールとプロバイダーで情報を補完する。 現在の会社、役職、情報源、関連コンテキストを追加します。出所情報を保持します。
- 構文、DNS、SMTP、キャッチオール動作を検証する。 結果、理由コード、タイムスタンプを保存します。
- メール到達率のリスクでセグメント化する。 無効、ロールベース、使い捨て、キャッチオール、無料 Web メール、低リスクの個人名付きアドレスを分けます。
- 適法な根拠を確認する。 関連するプライバシーフレームワークの下で、チームが連絡先を処理・利用できる理由を文書化します。
- 抑制と送信者管理を適用する。 オプトアウトを尊重し、送信者を明確に識別し、抑制レコードが今後のキャンペーンに再び入らないようにします。
- 監視して再検証する。 バウンス、苦情、遅延、エンゲージメントを追跡し、次のシーケンスの前に古くなったレコードを更新します。
コンプライアンス層は、送信システムが決して参照しないポリシー文書ではなく、ワークフローの中に組み込む必要があります。すべての連絡先について明確な監査証跡を維持し、キャンペーンを受け取るべきでないロールベースおよび個人用アドレスを抑制し、適用される DNSBL とスパムトラップの情報を尊重し、キャンペーンまたは管轄区域で必要な場合はダブルオプトインを使用します。チームは、データソースが意図した利用を許可しているか、また保持が引き続き必要かも確認する必要があります。
この短いランブックをアウトバウンドプロセスのそばに置きます。レコードの情報源を確認し、慎重に推測し、合法的に情報を補完し、直ちに検証し、リスクをスコアリングし、例外を抑制し、適格な連絡先だけをシーケンスに追加し、古いデータを再確認する。この手順により、「メールアカウントを見つける」作業は、スクレイピングではなく、管理された収益活動になります。
BillionVerify は、単一検証、一括リストクリーニング、リアルタイムワークフロー向けのプロフェッショナルなメール検証を提供し、発見から検証までのプロセスを支援できる、構造化されたメール到達率およびリスクデータを提供します。BillionVerify にアクセスして、その検証ツールがアウトリーチシーケンスに到達する前にリスクの高いアドレスを除去する方法をご確認ください。