

Przedstawiciel handlowy pobiera świeżą listę potencjalnych klientów, wyszukuje adresy za pomocą narzędzia do znajdowania e-maili i ładuje każdy wynik do sekwencji kontaktów. Lista wygląda na kompletną, ale liczba odpowiedzi pozostaje niska, liczba odbić rośnie, a reputacja nadawcy, budowana przez miesiące, zaczyna się pogarszać. Problemem zwykle nie jest brak danych. Chodzi o założenie, że znaleziony adres jest automatycznie osiągalny, aktywny, odpowiedni i bezpieczny do kontaktu.
Aby znajdować konta e-mail, które faktycznie konwertują, traktuj wyszukiwanie jako pierwszy etap połączonego procesu. Wzbogacanie danych dodaje kontekst, weryfikacja sprawdza techniczną osiągalność, a ocena ryzyka określa, czy adres powinien trafić do sekwencji, wymaga przeglądu, czy powinien zostać wykluczony. To rozróżnienie ma znaczenie w rozdrobnionym ekosystemie skrzynek pocztowych, w którym globalne badanie z 2024 roku obejmujące 15 dostawców usług e-mail wykazało średnią dostarczalność do skrzynek odbiorczych na poziomie 83,1%, co oznacza, że 16,9% legalnych wiadomości e-mail nie trafiło do skrzynki odbiorczej (statystyki dostarczalności EmailToolTester).
Weryfikacja rzeczywistości prospectingu emailowego w 2026 roku
SDR może zbudować dużą bazę potencjalnych klientów w jedno popołudnie. Nazwiska pochodzą od dostawcy danych, stanowiska są uzupełniane na podstawie profili zawodowych, a narzędzie wyszukujące generuje prawdopodobny adres dla każdej osoby. Początkowo kampania może wyglądać na skuteczną, ponieważ sekwencja jest pełna, a dane mają uporządkowaną strukturę. Następnie domena wysyłająca zaczyna otrzymywać odroczenia, wiadomości trafiają do ogólnych adresów, a zespół odkrywa, że wiele „prawidłowych” kontaktów od początku nie było dobrymi potencjalnymi klientami.
Procesy oparte wyłącznie na wyszukiwaniu przynoszą coraz mniejsze korzyści, ponieważ dostawcy skrzynek pocztowych oceniają więcej niż tylko to, czy adres istnieje. Analizują historię nadawcy, wzorce zaangażowania, sygnały uwierzytelniania, treść wiadomości oraz zachowanie odbiorców. Technicznie osiągalna skrzynka nadal może przekierować wiadomość do spamu, zignorować ją lub powiązać nadawcę z niepożądanym kontaktem.
Praktyczna zasada: Większa lista nie jest lepszą listą, jeśli zespół nie potrafi wyjaśnić, dlaczego każdy adres jest osiągalny i wart kontaktu.
Starsze podejście było proste: zebrać adresy, załadować je do sekwencji, a następnie usunąć odbicia. Taki proces traktuje problemy z dostarczalnością jako kwestię raportowania. Nowoczesny proces traktuje je jako problem danych przed wysyłką. Przydatny rekord to nie tylko name + email. Zawiera aktualne stanowisko danej osoby, kontekst firmy, źródło, metodę znalezienia, wynik weryfikacji, status catch-all, status konta funkcyjnego, oznaczenie domeny jednorazowej oraz sygnał zakupowy uzasadniający kontakt.
Skala współczesnej komunikacji emailowej wyjaśnia również, dlaczego różnorodność dostawców ma znaczenie. Gmail został uruchomiony w 2004 roku, Google poinformowało o 1 miliardzie miesięcznie aktywnych użytkowników w 2016 roku, a Gmail później przekroczył 1,8 miliarda użytkowników do 2020 roku, zgodnie z kontekstem historycznym podsumowanym przez EmailToolTester. Znajdowanie kont emailowych oznacza dziś pracę z dostawcami konsumenckimi i biznesowymi o różnym sposobie filtrowania, a nie dopasowywanie nazwiska do znanej domeny.
Prospecting oparty na AI i weryfikacja w czasie rzeczywistym stają się kluczowe dla tej zmiany, podczas gdy przepisy dotyczące prywatności utrudniają obronę bezrefleksyjnego gromadzenia danych. Omówienia branżowe wskazują te zmiany jako najważniejsze wydarzenia na rynku narzędzi do wyszukiwania adresów email (current email finder workflow coverage). Praktyczny wniosek jest prosty: wyszukiwanie dodaje kandydata do listy, ale weryfikacja i ocena ryzyka decydują, czy kandydat powinien trafić do działań outreachowych. Szersze omówienie tego, jak automatyzacja zmienia operacje emailowe, znajdziesz w BillionVerify AI email Bible, który stanowi przydatne źródło uzupełniające.
Operatory wyszukiwania i zgadywanie wzorców jako podstawa
Operatory wyszukiwania pozostają przydatne, gdy ujawniają publiczny kontekst zawodowy, a nie prywatne informacje osobowe. Zacznij od domeny firmy i stanowiska danej osoby, a następnie zawężaj wyszukiwanie:
site:linkedin.com "@company.com" intitle:"VP Operations"
Używaj cudzysłowów wokół dokładnych nazw lub fragmentów domen. Dodaj lokalizację, jednostkę biznesową albo poprzedniego pracodawcę, gdy wyniki są zbyt liczne. Wariant filetype:pdf może ujawnić biografie konferencyjne, strony prelegentów, dokumenty inwestorskie i inne materiały publiczne, w których może pojawić się adres zawodowy. Operatory wykluczające pomagają usuwać nieistotne wyniki, na przykład:
site:example.com "@example.com" -jobs -careers
Te zapytania nie potwierdzają, że adres jest aktywny. Dostarczają dowodów na potrzeby wzbogacania danych i pomagają odróżnić skrzynkę imienną od ogólnego adresu, takiego jak info@, support@ lub sales@.
Zbuduj wzorzec domeny
Zgadywanie wzorców działa najlepiej, gdy znasz już domenę i masz kilka potwierdzonych przykładów. Zbierz od pięciu do dziesięciu znanych adresów z publicznych stron firmowych, wcześniejszych rozmów lub dozwolonych źródeł danych. Ujednolić wielkość liter, usuń aliasy i pogrupuj formaty takie jak:
first.last@example.comflast@example.comfirstl@example.comfirst@example.com
Następnie uszereguj wzorce według częstotliwości ich występowania. Jeśli jeden format wyraźnie dominuje, użyj go do utworzenia kandydującego adresu dla nowego kontaktu. Nie traktuj kandydującego adresu jako wyniku. Traktuj go jako dane wejściowe do weryfikacji.
W podsumowaniu badania porównawczego z 2026 roku podano, że samo zgadywanie wzorców osiągnęło około 60%, gdy znane były zarówno domena firmy, jak i imię oraz nazwisko danej osoby. To samo podsumowanie wykazało, że wskaźniki zweryfikowanego odnajdywania wynosiły od 20% do 77,5% w przypadku samodzielnych narzędzi w teście obejmującym 5000 kontaktów, co pokazuje, jak silnie wyniki zależą od jakości wzbogacania danych i zastosowanej metody (benchmark procesu wyszukiwania adresów email).
Dopasuj oczekiwania do dowodów
| Wzorzec | Przykład | Śr. współczynnik dopasowania |
|---|---|---|
| Imię i nazwisko | first.last@example.com | Zależny od domeny |
| Pierwsza litera imienia i nazwisko | flast@example.com | Zależny od domeny |
| Imię i pierwsza litera nazwiska | firstl@example.com | Zależny od domeny |
| Tylko imię | first@example.com | Zależny od domeny |
| Skrzynka stanowiskowa | sales@example.com | Nie jest dopasowaniem osobistym |
Domeny typu catch-all ograniczają zakres informacji, jakie mogą dostarczyć testy wzorców, ponieważ serwer pocztowy może akceptować niemal każdego odbiorcę. Rejestry WHOIS chronione prywatnością oraz konfiguracje poczty ukierunkowane na prywatność tworzą podobne luki informacyjne. W takich przypadkach zgadnięty adres może wyglądać wiarygodnie, nie dostarczając jednak użytecznego potwierdzenia.
Praktyczna sekwencja to wyszukaj, wywnioskuj, zweryfikuj i sklasyfikuj. Skorzystaj z przewodnika po masowym ekstraktorze emaili, aby poznać szerszy proces ekstrakcji, ale nie traktuj ekstrakcji jako miary sukcesu. Kandydujący adres ma wartość dopiero wtedy, gdy zespół zna jego status techniczny, typ skrzynki i ryzyko związane z nawiązaniem kontaktu.
LinkedIn, narzędzia wzbogacania danych i dostawcy danych — porównanie
LinkedIn jest skuteczny w ustalaniu tożsamości i kontekstu. Może pokazywać obecnego pracodawcę, stanowisko, lokalizację i historię kariery, co czyni go wartościowym narzędziem do prospectingu opartego na kontach. Zwykle nie dostarcza zweryfikowanego służbowego adresu dla każdej osoby, dlatego zespoły łączą go z narzędziem wzbogacania danych lub wyszukiwarką adresów e-mail.
Platformy wzbogacania danych, takie jak Apollo, Clearbit i systemy w stylu ZoomInfo, mogą połączyć osobę, domenę firmy i znany URL profilu z prawdopodobnym adresem służbowym. Ich zaletą jest szybkość pracy i szerszy, uporządkowany kontekst. Ich wadą jest to, że zasięg różni się w zależności od rynku, wielkości firmy, lokalizacji i tego, jak niedawno odświeżono poszczególne rekordy. Dostawcy danych masowych oferują dużą skalę i wygodny eksport, ale nieaktualne rekordy stwarzają ryzyko operacyjne, gdy zespoły przesyłają je bez etapu weryfikacji.
Porównanie kompromisów operacyjnych
| Kanał | Zasięg | Koszt/rekord | Aktualność | Zgodność |
|---|---|---|---|---|
| Analiza LinkedIn | Silny kontekst tożsamości i roli, szczególnie w przypadku widocznych specjalistów | Większy nakład pracy ludzkiej | Często odzwierciedla bieżącą aktywność profilu | Scraping może kolidować z warunkami korzystania z platformy |
| API wzbogacania danych | Przydatne do uporządkowanego dopasowywania firm i kontaktów | Zależny od użycia lub platformy | Zależy od cykli odświeżania źródła | Wymaga zgodnego z prawem gromadzenia, wykorzystywania i przechowywania danych |
| Dostawcy danych masowych | Szeroki zasięg na górze lejka | Niższy koszt krańcowy przy dużej skali | Bez weryfikacji dane mogą szybko tracić aktualność | Wymaga starannego śledzenia pochodzenia, reguł wykluczania i kontroli audytowych |
| Strony firmowe i publiczne dokumenty | Duża trafność w przypadku opublikowanych kontaktów | Niski bezpośredni koszt pozyskania, większy nakład pracy badawczej | Zmienia się wraz z aktualizacjami strony | Należy wykorzystywać wyłącznie informacje odpowiednie dla zamierzonego kontaktu |
W przypadku bardziej szczegółowych ram wyboru między tymi kategoriami przydatnym źródłem jest porównanie narzędzi wzbogacania danych, ponieważ decyzja obejmuje więcej niż liczbę funkcji. Zasięg w małych firmach różni się od zasięgu w przedsiębiorstwach, a pozornie niski koszt pozyskania może zniknąć, gdy zespół płaci za ręczną weryfikację, obsługę odbić i zastępowanie list.
Warunki LinkedIn ograniczają niektóre formy automatycznego scrapingu. GDPR wpływa na podstawę prawną, przejrzystość, przechowywanie i wykorzystywanie danych osobowych. CAN-SPAM reguluje praktyki dotyczące komercyjnej poczty e-mail w Stanach Zjednoczonych, podczas gdy CASL nakłada bardziej rygorystyczne wymogi dotyczące zgody na wiele kanadyjskich wiadomości komercyjnych, szczególnie w kontekście konsumenckim. Przegląd prawny powinien uwzględniać lokalizację odbiorcy, rolę nadawcy, źródło danych i rodzaj kampanii.
Najtańszy rekord to często ten, który wymaga najmniej późniejszych korekt.
Korzystaj z LinkedIn i wzbogacania danych przy intensywnych działaniach opartych na kontach, gdy dokładność roli ma znaczenie. Dostawcę danych masowych wykorzystuj do szerokiego prospectingu tylko wtedy, gdy proces obejmuje kontrolę pochodzenia danych, logikę wykluczania i weryfikację. Wyszukiwarka adresów e-mail LinkedIn BillionVerify może pasować do ścieżki od odkrywania do weryfikacji, ale decyzja nadal powinna opierać się na jakości danych i zamierzonym wykorzystaniu, a nie wyłącznie na nazwie źródła.
Jak naprawdę działa weryfikacja od kulis
Weryfikacja adresu e-mail nie sprowadza się do jednego pytania „tak” lub „nie”. To sekwencja testów, która odpowiada na różne pytania dotyczące tego samego adresu.
Pierwsza warstwa sprawdza sam adres
Walidacja składni sprawdza, czy ciąg znaków odpowiada akceptowalnemu formatowi adresu e-mail. Wykrywa nieprawidłowo sformatowane adresy, przypadkowe spacje, brakujące elementy domeny i inne oczywiste błędy, zanim system wykona testy sieciowe. Ta warstwa powinna również identyfikować konta funkcyjne, takie jak info@, support@ i sales@.
Konto funkcyjne nie musi być niedostarczalne. Oznacza inną decyzję dotyczącą kontaktu. Skieruj je do procesu obsługi wspólnej skrzynki odbiorczej lub kontaktu z firmą, zamiast traktować je jak adres konkretnej osoby.
Druga warstwa sprawdza domenę
Testy DNS i MX określają, czy domena jest rozpoznawana oraz czy ma serwer pocztowy zdolny do odbierania wiadomości. Domena może istnieć, ale nie być prawidłowym miejscem docelowym dla analizowanego adresu. Zaparkowane domeny, nieprawidłowo skonfigurowane domeny i hosty typu sinkhole mogą sprawić, że adres będzie wyglądał na bardziej wiarygodny, niż jest w rzeczywistości.
Trzecia warstwa analizuje zachowanie skrzynki pocztowej
Handshake SMTP łączy się z serwerem pocztowym odbiorcy, identyfikuje zamierzonego odbiorcę i odczytuje odpowiedź serwera bez wysyłania wiadomości. Standardowy proces sprawdza składnię, kondycję domeny i odpowiedź na poziomie skrzynki pocztowej (jak działa weryfikacja adresów e-mail).
Domeny catch-all komplikują ostatnią warstwę. Jeśli serwer akceptuje każdego odbiorcę, system weryfikujący może otrzymać taką samą odpowiedź akceptującą zarówno dla istniejącej skrzynki, jak i dla wymyślonego adresu. Taki wynik należy sklasyfikować jako catch-all, a nie podnosić go do kategorii „bezpieczny”. Domeny jednorazowe również wymagają osobnej flagi, ponieważ tymczasowe skrzynki mogą być technicznie osiągalne, a jednocześnie nie nadawać się do trwałej komunikacji sprzedażowej lub marketingowej.
Przydatna odpowiedź z weryfikacji powinna ujawniać więcej niż jeden status. Dokumentacja API BillionVerify opisuje ustrukturyzowane pola dotyczące statusu, dostarczalności, wyniku jakości, poziomu ryzyka, kodów przyczyn oraz osobne flagi dla adresów jednorazowych, kont funkcyjnych, domen catch-all i bezpłatnych usług pocztowych. Podaje również, że API odpowiada w czasie krótszym niż 3 sekundy (API walidacji adresów e-mail).
Wynik powinien uruchamiać konkretne działanie. Wykluczaj nieprawidłowe rekordy, kieruj konta funkcyjne do innej obsługi, wstrzymuj domeny catch-all do czasu weryfikacji, oddzielaj adresy jednorazowe od trwałych działań oraz przekazuj niskiego ryzyka adresy imienne do kolejnego etapu oceny.
Włączanie weryfikacji do stosu narzędzi do outreachu
Weryfikacja działa najlepiej jako punkt kontrolny w toku działań, a nie jako zadanie porządkowe po nieudanej kampanii. Właściwa integracja zależy od tego, gdzie Twój zespół tworzy rekordy i jak szybko te rekordy muszą być przekazywane dalej.
Weryfikacja API w czasie rzeczywistym
Scraper, usługa wzbogacania danych lub proces kaskadowy może wywołać API weryfikacyjne natychmiast po wygenerowaniu adresu. System zapisuje odpowiedź obok danych kontaktu i blokuje nieprawidłowe lub obarczone wysokim ryzykiem rekordy, zanim trafią do CRM. Ten model sprawdza się w działaniach na dużą skalę, ponieważ zapobiega rozprzestrzenianiu się nieprawidłowych danych w wielu systemach zależnych.
Kompromisem jest synchroniczne opóźnienie i koszt użytkowania. Wywołanie w czasie rzeczywistym dodaje punkt decyzyjny do procesu wzbogacania danych, ale pozwala uniknąć kosztów ręcznego naprawiania skutków wysyłki przed czyszczeniem danych.
Walidacja po stronie CRM
Workflow w HubSpot lub Salesforce może uruchomić etap weryfikacji, gdy lead otrzyma status kwalifikowany, albo bezpośrednio przed zapisaniem go do sekwencji. Niestandardowy kod lub konektor automatyzacji może zapisać wynik w polach takich jak verification_status, risk_level, catch_all i last_verified_at.
To podejście jest przydatne, gdy wiele kanałów pozyskiwania zasila jeden CRM. Ryzykiem jest czas. Jeśli ten sam adres został zweryfikowany dawno temu, kontrola przed rozpoczęciem sekwencji jest bardziej niezawodna niż poleganie na starej wartości.
Workflowy agentów AI i MCP
Agenci AI mogą używać weryfikacji jako wywołania narzędzia podczas autonomicznego prospectingu. Agent znajduje osobę, wzbogaca rekord, przesyła kandydata do weryfikacji i zatrzymuje się lub prosi o sprawdzenie, gdy odpowiedź wskazuje adres catch-all, jednorazowy, funkcyjny albo wysokie ryzyko.
Ten model nie pozwala agentowi traktować wiarygodnie wyglądającego ciągu znaków adresu email jako ukończonego wyniku. Tworzy także wyraźną granicę pewności. Agent może kontynuować tylko wtedy, gdy dowody spełniają zasady kampanii.
| Model | Punkt wyzwalający | Opóźnienie | Najlepsze zastosowanie | Kompromis |
|---|---|---|---|---|
| API | Natychmiast po znalezieniu lub wzbogaceniu danych | Niemal w czasie rzeczywistym | Procesy na dużą skalę i kaskadowe wzbogacanie | Dodaje wywołanie i wymaga obsługi błędów |
| MCP | Podczas sekwencji prospectingu agenta AI | Zależne od wywołania narzędzia | Autonomiczne wyszukiwanie z progami pewności | Wymaga starannie zdefiniowanych uprawnień agenta |
| CRM | Przed kwalifikacją lub zapisaniem do sekwencji | Zależne od workflow | Scentralizowane operacje sprzedażowe | Może nastąpić zbyt późno, jeśli nieprawidłowe dane już się rozprzestrzeniły |
Stosuj trzy wyzwalacze operacyjne: weryfikuj po scrapowaniu, weryfikuj bezpośrednio przed rozpoczęciem sekwencji oraz ponownie weryfikuj starzejące się rekordy zgodnie z ustalonym harmonogramem. Praktyczny workflow email powinien uwzględniać ryzyko związane ze skrzynką pocztową i dostarczalnością wiadomości, zamiast polegać na pojedynczym sprawdzeniu. Wskazówki dotyczące dostarczalności cold email mogą pomóc zespołom połączyć kontrole techniczne z praktykami wysyłki.
Weryfikację przed wysyłką można mierzyć. Jeden z benchmarków z 2026 roku wykazał współczynnik twardych odbić poniżej 0,5% wśród marketerów, którzy weryfikowali listy przed kampaniami, w porównaniu z 1,8% do 3,2% w przypadku nieweryfikowanych wysyłek w tych samych branżach (benchmarki współczynnika odrzuceń email). Umieść weryfikację przed rozgrzewaniem i wysyłką, a nie po otrzymaniu pierwszego raportu o odbiciach. W przypadku zespołów przetwarzających istniejące bazy danych weryfikacja list email metodą bulk powinna odbywać się przed przekazaniem pliku do narzędzia sekwencjonującego.
Dlaczego prawidłowy adres nie jest bezpiecznym adresem
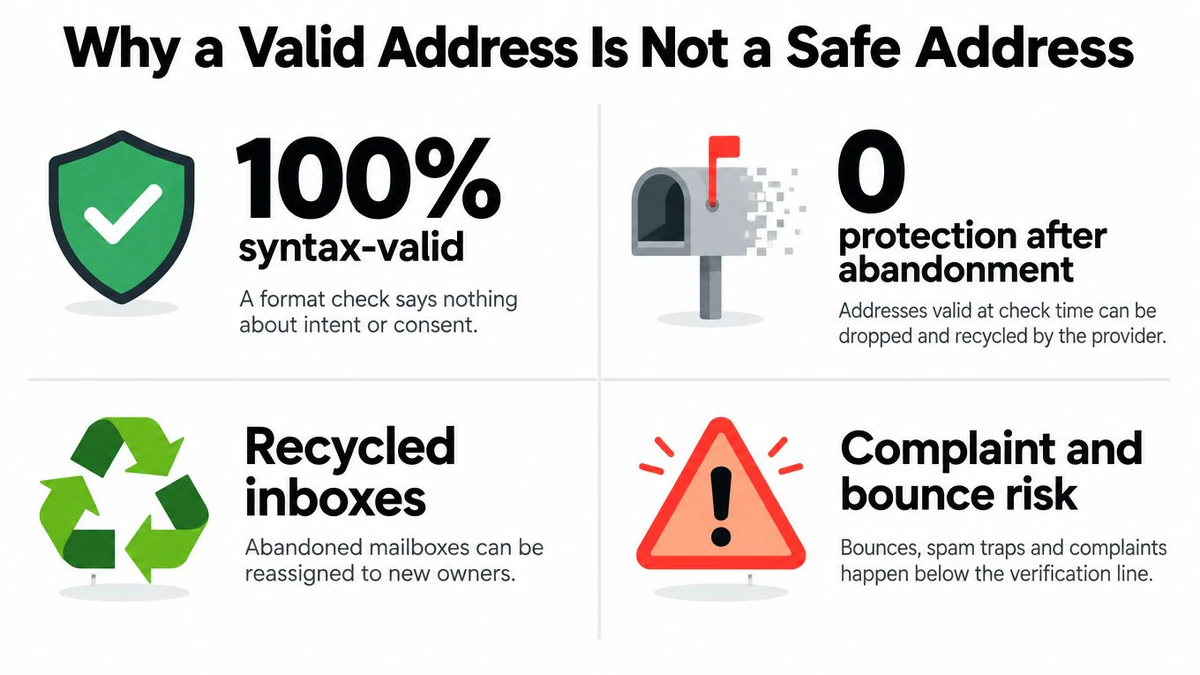
Zielony wynik weryfikacji odpowiada na wąskie pytanie: adres był technicznie osiągalny w momencie przeprowadzania testu. Nie potwierdza jednak, że dana osoba chce otrzymać Twoją wiadomość, skrzynka pozostaje aktywna ani że domena ma dobrą reputację u Twojego nadawcy.
Adres może przejść kontrole składni, a mimo to należeć do konta funkcyjnego. Domena może akceptować ruch SMTP, jednocześnie agresywnie filtrując nieznanych nadawców. Skrzynka może być prawidłowa dziś, a później zostać porzucona. Kontakt może też pozostać całkowicie osiągalny, a jednocześnie zgłosić Twoją wcześniejszą wiadomość jako spam, co stwarza problem ryzyka dla nadawcy, którego nie rozwiąże żadna sonda skrzynki pocztowej.
Oddziel ważność techniczną od ryzyka kampanii
Przechowuj te pojęcia w osobnych polach:
- Status skrzynki pocztowej: Czy system odbiorczy zaakceptował sondę weryfikacyjną.
- Typ adresu: Czy kontakt jest konkretną osobą, kontem funkcyjnym, bezpłatnym adresem webmail lub jednorazową skrzynką pocztową.
- Zachowanie domeny: Czy domena jest typu catch-all lub zwraca odpowiedź ograniczającą pewność.
- Ryzyko zaangażowania: Czy wcześniejsze wysyłki nie przyniosły zaangażowania, skarg, odroczeń lub innych negatywnych sygnałów.
- Status zgody: Czy odbiorca zrezygnował z subskrypcji lub nie ma możliwej do obrony podstawy prawnej dla zamierzonej komunikacji.
Na dużą skalę weryfikacja może obserwować znaczną część warstwy SMTP, ale nie może zagwarantować przyszłego dostarczenia do skrzynki odbiorczej. Benchmark z 2026 roku obejmujący 10 241 981 weryfikacji w 293 934 domenach wykazał 12,3% nieprawidłowych adresów, 33,1% domen typu catch-all oraz zaledwie 19% ponownie sprawdzonych adresów, które nadal były prawidłowe po 90 dniach (benchmarki dostarczalności wiadomości e-mail). Liczby te jasno pokazują jeden wniosek operacyjny: stary pozytywny wynik nie powinien obowiązywać wiecznie.
Prawidłowy adres to migawka. Bezpieczna decyzja dotycząca kontaktu to aktualizowany rekord.
Ponowną weryfikację należy uruchamiać na podstawie wieku danych, wrażliwości kampanii i kategorii ryzyka. Wycofuj adresy, które nie przejdą późniejszych kontroli, izoluj adresy typu catch-all do bardziej rygorystycznej oceny i przestań wysyłać wiadomości do kontaktów, które zrezygnowały z subskrypcji lub generują sygnały skarg. Ciągłe dbanie o higienę danych nie eliminuje każdego problemu z reputacją, ale zapobiega myleniu wcześniejszej odpowiedzi technicznej z trwałą gwarancją.
Kompletny przepływ pracy i lista kontrolna zgodności
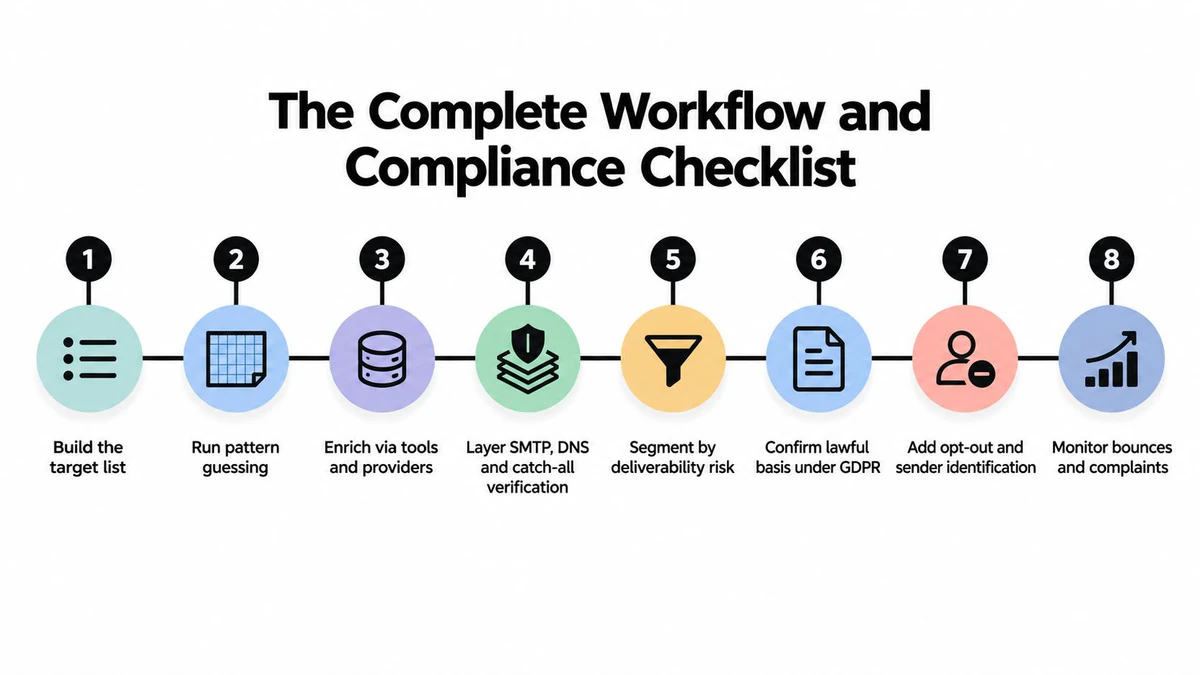
Niezawodny proces przeprowadza każdy rekord przez te same etapy:
- Zbuduj listę docelową. Zdefiniuj konto, stanowisko, lokalizację geograficzną i sygnał zakupowy. Wynikiem powinien być rekord kontaktu ze źródłem i powodem uwzględnienia.
- Uruchom zgadywanie wzorców. Wykorzystaj publiczne dowody i znane formaty domen, aby utworzyć kandydatów. Wynikiem powinien być potencjalny adres, a nie założona prawda.
- Wzbogać dane za pomocą dozwolonych narzędzi i dostawców. Dodaj aktualną firmę, stanowisko, źródło i istotny kontekst. Zachowaj pochodzenie danych.
- Zweryfikuj składnię, DNS, SMTP i działanie catch-all. Zapisz wynik, kody przyczyn i znacznik czasu.
- Podziel kontakty według ryzyka dostarczalności. Oddziel adresy nieprawidłowe, funkcyjne, jednorazowe, catch-all, bezpłatne adresy webmail oraz adresy imienne o niższym ryzyku.
- Potwierdź podstawę prawną. Udokumentuj powód, dla którego zespół może przetwarzać i wykorzystywać kontakt zgodnie z odpowiednimi przepisami dotyczącymi prywatności.
- Zastosuj wykluczenia i kontrolę nadawcy. Respektuj rezygnacje z subskrypcji, jasno identyfikuj nadawcę i zapobiegaj ponownemu uwzględnianiu wykluczonych kontaktów w przyszłych kampaniach.
- Monitoruj i ponownie weryfikuj. Śledź zwroty, skargi, odroczenia i zaangażowanie, a następnie odświeżaj starzejące się rekordy przed rozpoczęciem kolejnej sekwencji.
Warstwa zgodności powinna znajdować się wewnątrz przepływu pracy, a nie w dokumencie dotyczącym zasad, którego system wysyłkowy nigdy nie odczytuje. Prowadź przejrzysty rejestr audytowy dla każdego kontaktu, wykluczaj adresy funkcyjne i osobiste, które nie powinny otrzymywać kampanii, respektuj odpowiednie informacje DNSBL i dotyczące pułapek spamowych oraz stosuj podwójne potwierdzenie subskrypcji tam, gdzie wymaga tego kampania lub jurysdykcja. Zespoły powinny również sprawdzać, czy źródło danych zezwala na planowane wykorzystanie oraz czy przechowywanie danych jest nadal konieczne.
Umieść tę krótką instrukcję obok procesu outbound: pozyskaj rekord, wnioskuj ostrożnie, wzbogacaj dane zgodnie z prawem, natychmiast weryfikuj, oceniaj ryzyko, wykluczaj wyjątki, uwzględniaj wyłącznie uprawnione kontakty w sekwencji i ponownie sprawdzaj starzejące się dane. Taka sekwencja zmienia „znajdowanie kont e-mail” z ćwiczenia polegającego na scrapingu w kontrolowaną operację generowania przychodów.
BillionVerify zapewnia profesjonalną weryfikację adresów e-mail dla pojedynczych sprawdzeń, czyszczenia dużych list i procesów działających w czasie rzeczywistym, oferując uporządkowane dane dotyczące dostarczalności i ryzyka, które mogą wspierać proces od wyszukania do weryfikacji. Odwiedź BillionVerify, aby ocenić, jak jego narzędzia walidacyjne mogą pomóc Twojemu zespołowi usuwać ryzykowne adresy, zanim trafią do sekwencji kontaktowej.